问题:一段流畅的回答,一个没有依据的价格
假设某球队的票务经理把下周六比赛的基本信息输入一个通用文字大模型:对手是联赛中游球队,场馆4.2万座,东看台下层原价280元,问它应该怎么调价。模型很快回复:“考虑到周末需求较高和对手具有一定吸引力,建议东看台下层上调至320元左右,同时关注销售情况。”
这段回答读起来很专业,但每一个判断都没有依据。“周末需求较高”是泛泛而谈,模型不知道这支球队周六比赛的历史上座率;“对手具有一定吸引力”是从语言中推测的,而不是从过往对阵数据中得出的;“320元”这个数字没有经过任何计算,它不知道东看台还剩多少座位,也不知道此刻的订单速度是快是慢。如果票务经理照此执行,可能在需求一般的比赛里把价格提高了一成多,结果是上座率下降。
问题不在于模型能力不够,而在于它被放在了错误的位置上。体育动态定价是一个需要多种数据和多个专门模型配合的问题,文字大模型只是其中一个环节。
数据:定价需要哪些数据,它们从哪里来
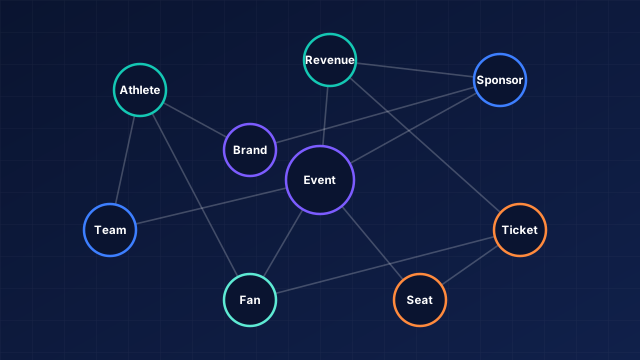
一个可用的体育动态定价系统,至少需要以下几类数据和组件:
| 组件 | 负责的内容 | 文字大模型能否替代 |
|---|---|---|
| Historical Data 历史数据 | 过往比赛的分区销售曲线、价格和上座率 | 不能,需要真实记录 |
| Inventory 库存 | 各区域可售、预留、会员配额和已售数量 | 不能,需要实时读取票务系统 |
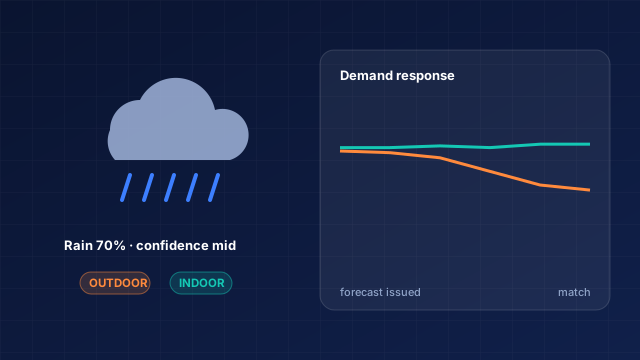
| Real-time Data 实时数据 | 订单速度、页面浏览、天气和赛况变化 | 不能,需要持续接入 |
| Demand Model 需求模型 | 估算不同价格下各区域的需求变化 | 不能,需要统计建模 |
| Forecast Model 预测模型 | 预测距开赛不同时间点的销售走势 | 不能,需要数值预测 |
| Pricing Engine 定价引擎 | 在规则和约束下计算候选价格方案 | 不能,需要优化计算 |
这六个组件都需要精确的数字。文字大模型从训练数据中学到的是语言规律,它可能知道“需求高时价格可以上调”这类常识,但不知道某一支球队、某一个看台、某一天的具体情况。更重要的是,它生成数字的方式是预测下一个词,而不是做计算,同样的问题问两次,可能得到两个不同的价格。
模型:语言模型负责什么,不负责什么
在皇冠体育大模型的定价系统中,语言模型有明确的分工。它负责的事情包括:理解用户用自然语言提出的问题,例如“东看台为什么卖得慢”;把问题翻译成对数据和数值模型的查询;把数值模型的结果组织成易于理解的解释;帮助运营人员起草定价规则的文字说明和对外公告。
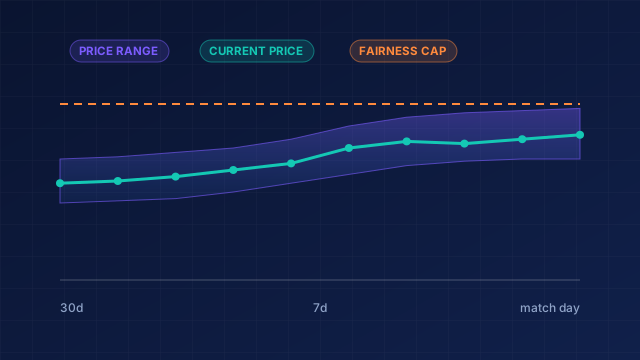
它不负责的事情同样明确:不直接计算价格,不直接预测销售数字,不直接修改票务系统中的价格,也不绕过定价规则中的价格区间和会员保护条款。价格由定价引擎在需求模型和预测模型的输入下计算,语言模型只负责说明这个价格是怎么来的。
这种分工的好处是可以追责。如果一个价格出了问题,可以回到需求模型检查参数,回到历史数据检查样本,回到定价引擎检查约束条件,而不是面对一段无法复现的文字。
分析:一次完整的定价分析是怎样走的
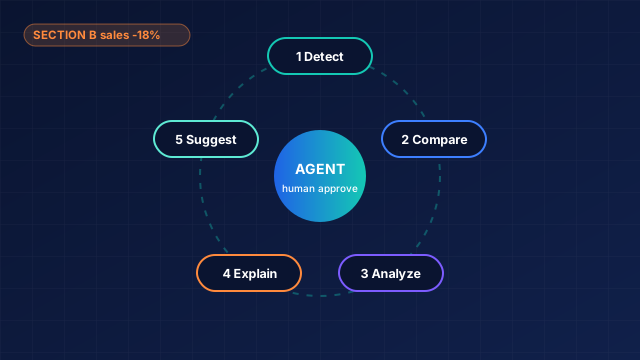
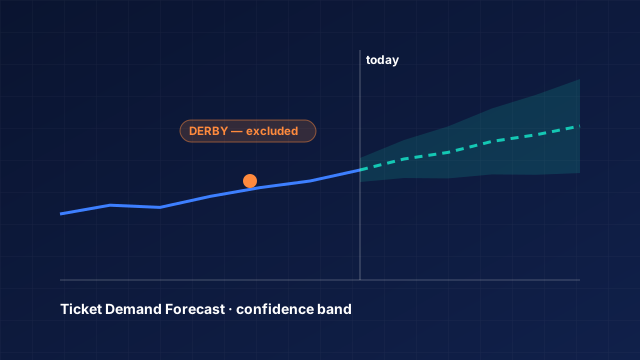
同样是“下周六东看台该怎么定价”这个问题,在完整系统中的处理路径大致是:语言模型识别出问题涉及的比赛、看台和时间窗口;系统读取东看台当前库存和已售数量;需求模型根据历史同类比赛估算不同价格下的需求;预测模型给出距开赛七天、三天和一天的销售走势;定价引擎在价格区间、会员保护和最大调整幅度的约束下,计算出几个候选方案。
这里也可能判断错。例如需求模型所用的历史样本来自上个赛季,而本赛季球队战绩明显提升,历史曲线可能低估真实需求;实时数据如果漏掉了某个分销渠道的订单,库存判断就会偏差。所以每个方案都要附带数据来源和置信区间。
解释:让票务经理看懂每一个数字
在皇冠体育AI的完整系统里,输出不应该只是一个价格,而是一组方案和它们的依据。语言模型在这里发挥最大价值:它把需求弹性、预测区间、库存结构这些专业概念,转换成票务经理能直接理解的语言,例如“上调20元预计会让东看台下层上座率下降约4个百分点,多出的票务收入只有约2%”。它还会说明每个方案最容易出错的地方,以及应该在什么时间点重新检查。
人工决策:最后一步必须由人完成
即使系统给出了清晰的方案,是否执行也应该由人决定。定价决策涉及球迷关系、赞助商承诺、品牌形象和对外沟通,这些都不是模型能够完整评估的。在皇冠体育的设计中,任何价格变动都需要经过有权限的负责人审批,系统记录每一次决策的依据和执行人,方便事后复盘。
普通文字大模型不能单独完成体育动态定价,但它可以成为连接人和数值系统的桥梁。关于动态定价为什么不等于热门比赛自动涨价,可以阅读体育动态定价的真正含义;更多系统设计思路见体育商业大模型栏目。