一个周一早上的提醒:C区比预期慢了四成
假设一家中等规模俱乐部的主场有4万个座位,下周六晚上有一场普通联赛,对手处于积分榜中游。周一早上九点,票务经理还没打开后台,就收到了一条系统消息:北看台C区目前售出22%,而过去同类比赛在开赛前12天的平均售出率约为37%,偏差超过四成,已经超出正常波动范围。
如果这是一个传统的价格预测工具,故事到这里就结束了。它可能会顺手给出一个建议价格,比如“C区下调15%”,然后等待下一个问题。但这条消息后面还附着一份简短的调查记录:系统已经查过C区的价格变化、这场比赛的对手和天气、比赛时间、过去五场普通周末比赛的销售曲线,以及相邻B区和D区的销售情况,并给出了一个与价格无关的初步判断。
这就是体育商业AI正在发生的转变:从一个等人提问、给出数字的预测工具,变成一个会自己寻找收入问题、自己查询数据、把原因和建议一起交给人的经营Agent。这篇文章用这个模拟场景,拆解这类Agent是怎样工作的,它的权限边界在哪里,以及它可能在哪些地方判断错。
问题:从“这张票卖多少钱”到“哪里出了问题”
价格预测工具回答的问题是明确的:给定一场比赛、一个座位区域和一个时间点,建议价格是多少。这类工具有用,但它有两个局限。第一,它是被动的,只有当运营人员意识到某个区域有问题并主动去问时,它才会发挥作用;而很多收入问题恰恰是在没人注意的时候悄悄发生的。第二,它的输出只有价格,而价格往往不是问题的根源。
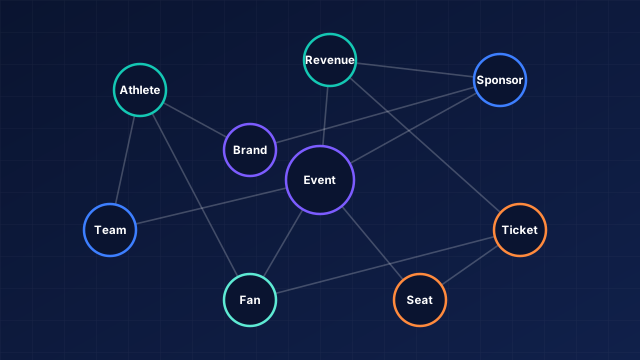
经营Agent要回答的是另一类问题:在所有正在销售的比赛和区域里,哪里的表现偏离了预期?偏离的原因最可能是什么?有哪些可选的动作?这些问题没有人提前写好,需要Agent自己从数据中发现,然后决定下一步去查什么。这种能力的前提,是模型对体育商业里的实体和关系有足够的理解:比赛、座位、库存、会员、价格、对手、天气之间是怎样相互影响的。关于体育商业大模型需要理解哪些实体,可以参考体育商业大模型到底需要理解哪些实体和商业关系。
数据:Agent自己去查了哪些东西
在C区这个场景里,皇冠体育AI的Agent在发出提醒之前,依次查询了以下几类数据:
- 价格:C区本场票价比上一场普通比赛上调了40元,这是赛季初设定的阶梯规则自动触发的。
- 对手:对手处于积分榜中游,历史上与本队的比赛上座率属于普通水平,不是德比或关键战。
- 天气:比赛日预报晴,气温适中,没有异常。
- 时间:周六晚上七点半开球,属于需求最好的时段之一,不存在工作日或节假日影响。
- 历史数据:过去五场普通周末比赛中,C区在开赛前12天的售出率在33%到40%之间,本场的22%明显低于这个区间。
- 相邻座位:相邻的B区和D区本场售出率分别为39%和36%,处于正常水平;而D区的票价同样上调了40元。
最后一项是关键。如果价格是主要原因,那么同样涨价的D区也应该变慢,但它没有。这让Agent把注意力从价格转向了C区本身在这场比赛里有什么不同。它继续查询了场馆运营数据,发现本场客队预计来访球迷较多,客队看台向C区一侧扩大,C区的入口因此从北侧一号门改为二号门,购票页面上新增了一条“需提前90分钟入场接受安检”的提示。页面数据显示,这条提示上线之后,C区从浏览到下单的转化率明显下降。
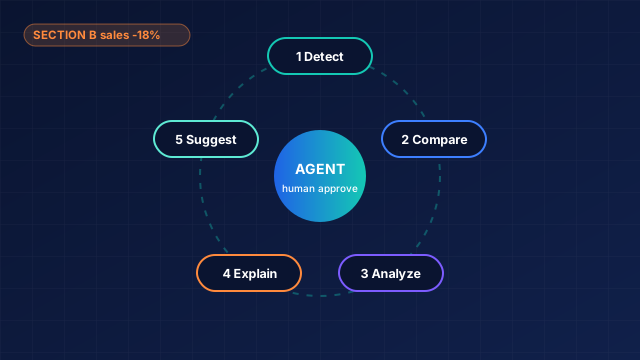
模型:Detect → Compare → Analyze → Explain → Suggest
把上面的过程抽象出来,就是一个五步的工作流程:
Detect:发现偏离
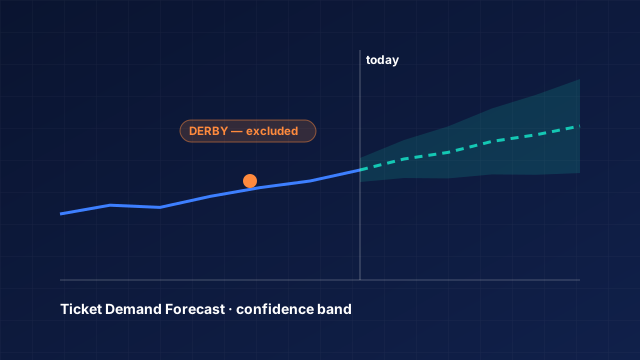
Agent定期巡检所有在售比赛和区域,把实际销售速度和预期曲线对比。预期曲线来自同类比赛的历史数据,并且已经剔除了德比、决赛、节假日等异常场次。只有当偏离超出正常波动范围时才触发,否则每天都会产生大量没有意义的提醒。
Compare:横向和纵向比较
发现偏离之后,Agent首先做比较:和同一区域的历史比,和同一场比赛的相邻区域比,和同一时段的其他比赛比。比较的目的是缩小范围,判断问题是整场比赛的、某个区域的,还是某个时间段的。
Analyze:逐个排查可能的原因
在缩小范围之后,Agent按照价格、对手、天气、时间、座位、库存、页面体验等维度逐个排查。每排除一个原因,就要说明依据,例如“D区同样涨价但销售正常,因此价格不太可能是主要原因”。
Explain:把原因写成人能看懂的话
分析的结果不能只是一个概率或者一个分数,而要写成运营人员能直接理解和核对的解释,包括依据了哪些数据、排除了哪些原因、还有哪些不确定。为什么解释比数字更重要,可以参考为什么体育商业AI必须告诉用户数字为什么变化。
Suggest:提出可选动作,而不是直接执行
最后一步是建议。建议应该是一组可选动作,每个动作附带预期效果、风险和观察周期,而不是一个单一的指令。
分析与解释:它最后交给票务经理的是什么
这份报告有几个特点。它没有直接说“降价”,因为证据指向的不是价格;它把每一个判断的依据都写了出来,票务经理可以逐条核对;它把建议分成了几个独立的动作,可以只采纳其中一部分;它主动说明了自己看不到什么。这些特点比预测的准确度更能决定一个Agent是否值得信任。
权限边界:可以查、可以算、可以建议,不能自己调价
Agent的能力越强,越需要清楚地划定它能做什么。在皇冠体育大模型的设计里,Agent的权限大致分成三层:
| 权限层级 | Agent可以做的事 | 需要人来做的事 |
|---|---|---|
| 读取与查询 | 读取销售、价格、库存、会员、天气、赛程等数据,自主决定下一步查什么 | 设定它能访问哪些数据源 |
| 分析与建议 | 比较、排查原因、写解释、提出多个可选动作 | 判断建议是否合理,补充Agent看不到的信息 |
| 执行 | 不执行调价、释放或回收库存、修改会员权益 | 审批并执行所有影响价格、库存和用户权益的动作 |
把执行权留给人,并不只是出于谨慎。调价会直接影响已经买票的用户和长期会员的信任,库存释放和回收会影响赞助商、客队和安保的安排,这些决定牵涉的利益方远远超出Agent能看到的数据范围。一个在数据上完全合理的调价,可能恰好发生在俱乐部和会员组织谈判的敏感期。Agent可以提醒这种风险,但不应该替人承担这种判断。
Agent可能在哪里判断错
即使流程设计得很完整,Agent仍然会犯错,而且有些错误比简单的预测偏差更隐蔽。
- 看不到线下信息。假设C区的一部分座位正在和一家企业洽谈团体包场,洽谈结果还没录入系统,Agent就会把这部分“慢”误判为异常,并给出不必要的建议。
- 把时间上的巧合当作原因。安检提示上线和转化率下降同时发生,不代表一定是提示导致的。如果同一时间C区的座位视角图也被更新了,Agent可能只抓住了其中一个变化。
- 排查路径被第一步带偏。Agent每一步查询都依赖上一步的结论,如果第一步的比较基准选错了,例如混入了一场节假日比赛,后面整条推理都会建立在错误的预期上。
- 过度报警。如果触发阈值设得太低,Agent会每天产生大量提醒,运营人员很快就会习惯性忽略它们,真正重要的提醒反而被淹没。
验证这些判断的方法,是让人参与关键节点:票务经理核对Agent的依据,补充它看不到的线下信息;对于建议中的动作,先选择影响小、可回退的一项执行,例如先改写安检提示,观察三天后再决定是否需要暂缓部分座位的销售;每一次采纳或否决,都作为反馈记录下来,用于调整Agent的比较基准和触发阈值。
人的决定:审批、反馈和责任
从价格预测工具到经营Agent,变化的不是模型会不会算,而是它开始主动承担“发现问题”和“组织证据”的工作。这让运营人员从大量的日常巡检中解放出来,把时间花在真正需要判断的地方。但判断本身,包括是否调价、是否改库存、是否调整会员权益,仍然属于人。
在C区这个模拟场景里,最终的决定可能是:采纳建议一,和安保部门协商后把入场提示改为“建议提前60分钟入场”,并在页面上补充二号门的路线图;暂不采纳建议二,因为客队球迷的实际数量还需要和客队确认;三天后再看转化率。这个决定综合了Agent的分析和Agent看不到的信息,也由做决定的人承担责任。
这也是体育商业大模型在经营场景里应有的位置:它负责更早发现、更快查清、更清楚地解释,人负责权衡、审批和担责。一个会自己寻找收入问题的Agent,价值不在于它替人做了多少决定,而在于它让每一个决定都建立在更完整的证据之上。